Vivimos tiempos extraños. Las máquinas hablan como si fuesen personas y las personas… bueno, las personas ya no hablan. Es curioso que uno de los principales mecanismos de los que se sirve el populismo y la desinformación sea exactamente el mismo que nos lleva a creernos, a pies juntillas, todo aquello que nos dicen los LLMs. Se llama trampa de fluidez —o de elocuencia— y es uno de los sesgos más peligrosos a los que nos enfrentamos cuando interactuamos con un modelo de lenguaje.
Se trata de un extraño mecanismo evolutivo por el que nuestro intelecto se desarma rápidamente si aquel —o aquello— con el que hablamos parece cargado de lógica y de razones. Nuestro cerebro, diseñado para alinear patrones, atribuye a nuestro locuaz interlocutor un grado de autoridad que, en realidad, no ha demostrado. De alguna manera asumimos que si alguien, o algo, habla moderadamente bien y exhibe razones sobre un tema que parecen plausibles es porque comprende ese tema. Ya sabéis que no. No hace falta que me ponga a contar chistes de cuñados.
Tu cuñado el LLM
En cierto modo los LLMs son como un negacionista del cambio climático: hilan argumentos peregrinos que, individualmente, pueden parecer plausibles, pensando en que al tejerlos juntos construyen un discurso sólido, pero olvidando que correlación no implica, en ningún caso, causalidad. Es exactamente lo que sucede cuando encadenas argumentos sin entender muy bien lo que estás diciendo. Exactamente lo que pasa con los modelos de lenguaje.
Interactuamos a diario con sistemas capaces de redactar ensayos filosóficos, programar en Python y resumir informes de cien páginas en segundos. La fluidez es tan apabullante que asumimos por inercia que si Claude o Gemini son capaces de algo así es porque "entienden" de qué están hablando. Sin embargo, lo que hay debajo es una ametralladora estadística de sintaxis que no tiene ni idea de semántica. Sufren lo que en ciencia cognitiva se denomina carencia de anclaje simbólico.
No me voy a extender demasiado en la estadística detrás del modelo porque esto ya lo expliqué en otro artículo en detalle. Lo que me interesa aquí es explicar qué sucede a nivel cognitivo y los riesgos que esta trampa de elocuencia tiene para cualquier trabajo de índole intelectual que dependa de ellos.
Comencemos por responder a una pregunta sencilla: ¿entiende la IA aquello que dice? No. En absoluto. Para entender este argumento sin recurrir a jerga matemática vamos a recurrir a la filosofía de la mente. El filósofo John Searle ideó en los años ochenta una analogía que sigue siendo brillante para mostrar en qué consiste esa absoluta falta de comprensión por parte de los modelos de lenguaje: la habitación China.
El duende bajo la máquina
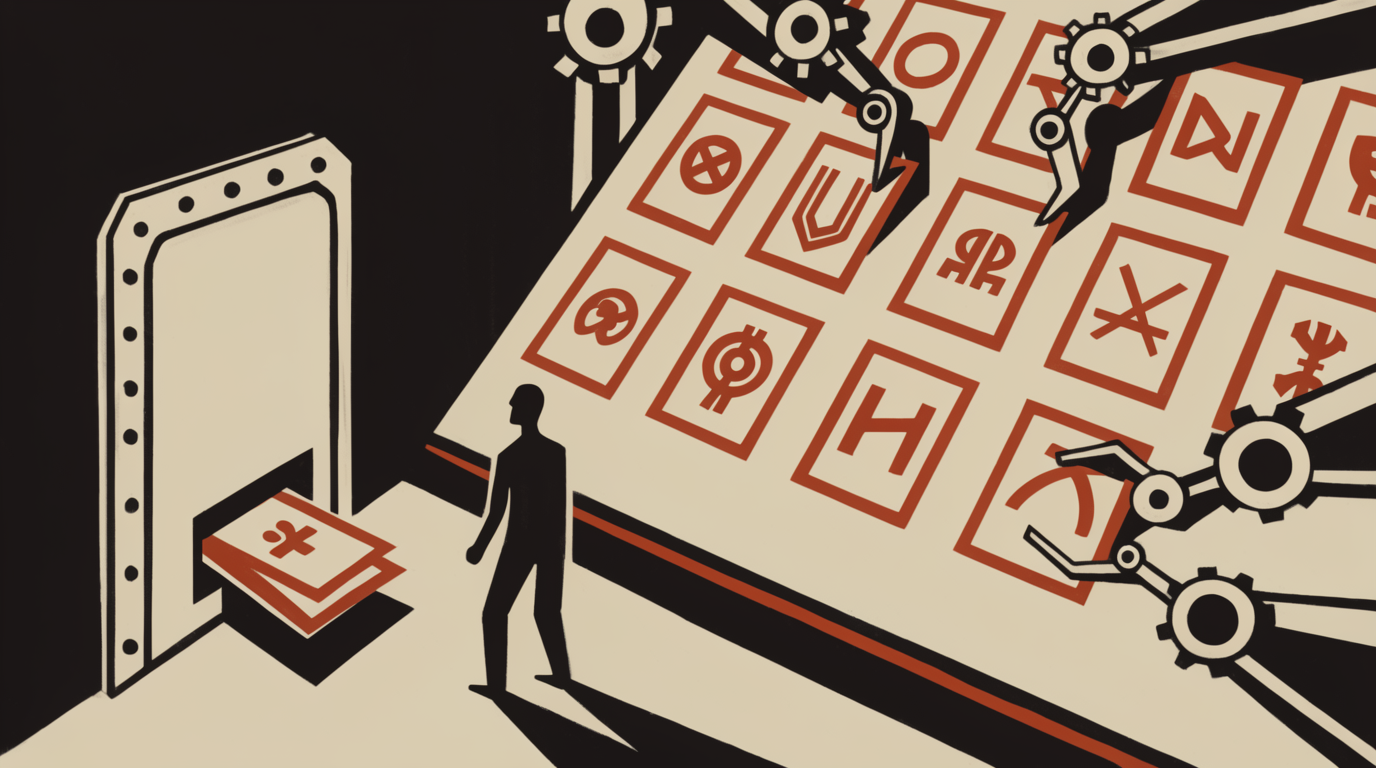
Imagina a una persona encerrada en una habitación. No habla ni lee una sola palabra de chino. Por una ranura en la puerta le pasan papeles con símbolos — los prompts. Dentro de la sala tiene un inmenso manual de instrucciones — los pesos estadísticos de la red neuronal — que le dicta reglas precisas: "Si te pasan el ideograma A junto al ideograma B, busca la tarjeta con el ideograma C y devuélvelo por la ranura." La persona obedece ciegamente. No puede hacer otra cosa. Para quien está fuera recibiendo el papel, la habitación domina el idioma a la perfección. Para el prisionero que está dentro, no hay lenguaje. Solo hay un trabajo mecánico de manipulación de tarjetas vacías de significado.
Los grandes modelos de lenguaje son esa habitación a escala industrial. Operan de forma aislada, manipulando tokens con una precisión probabilística asombrosa, sin comprender absolutamente nada de lo que procesan.
Searle publicó el experimento en 1980 en Minds, Brains, and Programs (Behavioral and Brain Sciences, 3:3) como argumento contra la Inteligencia Artificial fuerte — la hipótesis de que una máquina puede tener estados mentales reales. Cuarenta y cinco años después, el experimento no ha sido refutado. Ha sido ignorado por inconveniente: ejemplifica de manera clara y llana una situación incómoda para todos los profetas de la singularidad y sus acólitos los aceleracionistas.
El problema técnico de fondo es que un símbolo — una palabra — solo adquiere significado real cuando está anclado a un referente en el mundo físico, lógico o categórico. Nosotros sabemos qué es el fuego porque quema. Sabemos qué es el dolor porque lo hemos sentido. El significado no está en el símbolo en sí: está en la relación entre el símbolo y la experiencia que lo ancla.
La singular significancia del significado
Para la IA generativa, el lenguaje es un mapa sin territorio. Operan en espacios vectoriales continuos donde el concepto "fuego" es una coordenada matemática estadísticamente próxima a "calor" o "quemar". Sabe conjugar el verbo doler a la perfección gracias a la semántica distribucional, pero no tiene representación ontológica del dolor. No tiene mundo empírico con el que contrastar sus palabras. Para un LLM el significado de una palabra está asociado al entorno semántico en el que se integra, no al concepto en sí mismo.
Esto es lo que Stevan Harnad formalizó en 1990 como el Symbol Grounding Problem (Physica D, 42): un sistema puede manipular símbolos con precisión sintáctica perfecta aunque esos símbolos no estén anclados a ningún referente del mundo real. Las palabras no tienen significado intrínseco. Son coordenadas en un espacio de probabilidades.
Al carecer de significado per se, el discurso de un LLM se dota de coherencia semántica por una mera red de relaciones que responden a la frecuencia con que esas palabras aparecen juntas en el corpus de entrenamiento. Las implicaciones de eso — qué sesgos reproduce una máquina entrenada sobre la producción cultural de siglos de desigualdad — las desarrollaré en otro artículo.
Pero aquí me interesa centrarme en algo más inmediato: por qué nunca podemos dar por buena una afirmación surgida de un LLM. Siguiendo con la idea de la atribución de significado por contexto y la incapacidad de comprensión semántica, lo que tenemos es una máquina que responde basándose en intuiciones — tiene sentido unir estos dos conceptos porque siempre los he leído juntos — en lugar de deducciones — tiene sentido concatenar estas ideas porque se atribuyen modos de pensamiento análogos.
Si habéis leído a Kahneman (Thinking, Fast and Slow, 2011) — si no, deberíais — reconoceréis enseguida la dualidad: es su Sistema 1 frente a su Sistema 2. Al Nobel se le han quedado viejunas algunas referencias, pero su marco conceptual para entender los sistemas de pensamiento sigue siendo válido y viene al pelo para esta analogía: hablar con un LLM es, en esencia, como hablar con un humano elocuente que solo responde con prejuicios e ideas preconcebidas. Puede recombinarlas hasta cierto punto y nos dará la sensación de que concatena argumentos, pero nunca saldrá de su marco conceptual y mucho menos será capaz de cuestionarlo.
Dónde se dibuja el arco iris
Ya os imaginaréis el riesgo operativo concreto para alguien que trabaje con conocimiento, información, análisis o pensamiento crítico. Pero no he escrito este artículo para cargar contra el uso de modelos de lenguaje. No soy un neoludita. Uso la IA generativa intensivamente — sí, incluso en este artículo — pero soy perfectamente consciente de dónde me meto y por qué.
La trampa de fluidez es fácil de evitar una vez la ves. Y la mitigación no es técnica: es cognitiva. Siguiendo a Kahneman, hasta cierto punto se parece a la reestructuración cognitiva. Si me preparo para asumir que todo lo que me dice el LLM podría ser mentira — puesto que cada uno de sus argumentos podría ser una alucinación o, peor, una correlación sin causalidad — entonces mi proceso de trabajo no depende de la cadena de pensamientos del modelo. Si además construyo un contexto suficientemente sólido para suplir su carencia de anclaje y acoto el entorno de trabajo con una secuencia predeterminada, el LLM no tendrá más remedio que discurrir por el sendero que le he marcado, recurrir a las fuentes que le proporciono y construir el discurso sobre la base que yo le he dado.
Esto me hace, paradójicamente, menos dependiente del modelo. Claude, Gemini o GPT se convierten en una commodity intercambiable. Los usos de la herramienta están más acotados y reforzados con contexto externo, lo que significa que ni siquiera necesitas los modelos más potentes del mercado para hacer trabajo riguroso. Pero claro, esto requiere esfuerzo. Hay que activar el córtex prefrontal — el Sistema 2 — y trabajar un buen rato antes de siquiera abrir el chat. Con lo fácil que es darle a un botón. Y la dopamina que genera.
Fuentes y lecturas complementarias
Searle, J.R. (1980). Minds, Brains, and Programs. Behavioral and Brain Sciences, 3(3), 417-424. — El experimento mental de la Habitación China y el argumento contra la IA fuerte.
Harnad, S. (1990). The Symbol Grounding Problem. Physica D, 42, 335-346. — La formalización técnica del problema: por qué los símbolos necesitan anclaje empírico para tener significado.
Kahneman, D. (2011). Thinking, Fast and Slow. Farrar, Straus and Giroux. — La distinción entre Sistema 1 y Sistema 2, y por qué la fluidez lingüística activa confianza automática.
Wittgenstein, L. (1953). Philosophical Investigations. Blackwell. — El origen filosófico del problema del significado como uso: el significado no está en el símbolo sino en su práctica dentro de una forma de vida. Lectura densa pero fundacional.